

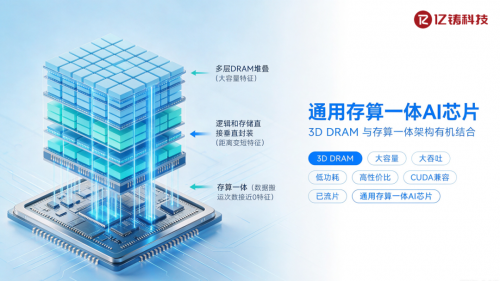
从技术底层逻辑来看,存算一体的核心价值,是从计算架构层面减少数据搬运带来的功耗与延迟损耗,这也是后摩尔时代算力提升的关键破局路径。亿铸科技是国内首家基于通用存算一体架构的AI大算力芯片公司,其核心技术路线的核心底座是3D DRAM与全数字存算一体架构的深度融合。区别于解决芯片间带宽互联问题的3D封装工艺,亿铸的全数字存算一体架构从计算架构本源出发,配合3D DRAM提供的海量容量基础,从根源上打破存储墙限制,极致压缩数据搬运路径与损耗。这一技术组合既保留了存储容量的可扩展性,又实现了计算效率的架构级提升,为AI大算力场景提供了兼顾容量与性能的硬件基础。
在实际性能表现上,亿铸科技的存算一体方案已实现能效与成本的双重突破。经第三方机构验证,基于传统工艺制程的全数字存算一体方案,能效比超出传统架构AI芯片平均性能的10倍以上;对比主流云端GPU,可实现约2倍性能提升、约1/5功耗、约1/6成本的综合表现。在大模型推理这一核心落地场景中,同等业务规模下的推理算力总拥有成本(TCO)最高可下降约88%,能够大幅降低数据中心的运营与扩容成本,为AI技术的规模化商业化落地提供了高性价比的算力底座选择。同时,方案可适配Agentic AI时代的新算力需求,支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化等特性,能够降低KV Cache检索延迟,提升长程任务处理能力与有效算力吞吐,适配智能体、大规模并行树搜索、环境模拟等新兴AI场景。
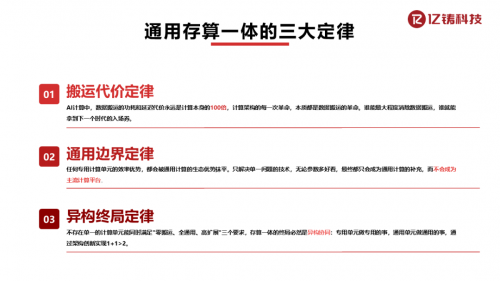
为了锚定长期技术路线,亿铸科技基于产业规律总结提出了通用存算一体三大定律,构成核心业务的底层判断框架。搬运代价定律指出,计算架构的每一次重要突破,本质上都围绕“更高效解决数据搬运”展开,3D DRAM、存算一体、3D封装三者融合是当前的最优技术组合;通用边界定律指出,专用计算单元的效率优势往往会被通用计算的生态优势抵消,只有兼顾生态兼容性的通用方案才能成为主流;异构终局定律指出,单一计算单元难以同时满足“零搬运、全通用、高扩展”三重要求,异构协同才是存算一体的发展终局。基于这三大定律,亿铸的存算一体方案同时具备架构通用、生态通用与计算通用三重属性:架构实现IP化,不绑定单一存储材料,为技术迭代预留空间;兼容CUDA生态与PyTorch框架,无需重构上层应用代码,可复用现有开发者生态与工具链,大幅降低迁移成本;存算一体IP与通用计算模块深度异构融合,既可以优化加速矩阵计算,又支持完整的通用计算任务,可独立承担AI计算工作而非仅作为协处理器存在。
依托全栈自研的技术能力,亿铸科技已形成覆盖云边端多场景的产品矩阵,从算力卡、工作站、一体机到推理集群,可满足不同规模、不同应用场景的算力需求。公司自研的YICA软件平台兼容主流开发生态,支持算子一键生成与优化,显著降低了客户的开发适配门槛。
团队层面,亿铸科技2022年正式开启规模化运营,总部位于苏州,在上海、杭州、成都、长沙设有子公司,团队规模近300人,研发人员占比超80%,工程团队核心成员平均拥有25年以上高端集成电路设计与量产经验,研发能力覆盖工艺器件、架构设计、电路设计和软件生态全链条,为核心业务的持续迭代提供了坚实支撑。目前,基于3D DRAM的全数字通用存算一体AI芯片已成功流片。
随着存算一体被纳入国家“十五五”规划,国产算力产业正迎来加速发展的关键窗口期。亿铸科技核心业务始终锚定通用存算一体的技术主赛道,以架构创新驱动算力效率提升,持续打磨全数字3D DRAM技术路线与全栈产品矩阵,为中国AI大算力产业提供自主可控的下一代算力底座,助力千行百业的智能化升级。